한국어 | English
AI를 최대한 활용해 사람들을 이롭게 하는 서비스를 개발하고자 합니다.
RAG 근거 충족률을 66.25%에서 91.25%로, AI 문서 편집 품질을 82.5%에서 91.2%로 높이며, AI가 틀린 근거로 답하거나 사용자 문서를 함부로 바꾸지 않도록 평가, 승인, 복구 구조를 설계해 온 AI 엔지니어입니다. 정확도와 비용, 응답 시간의 트레이드오프를 평가로 확인한 뒤 서비스에 맞는 구현을 선택합니다.
Email: kkuldangi2@gmail.com
- RAG 근거 선택 개선: 근거 충족률 66.25% → 91.25%, 답이 없는 질문에 근거를 붙인 경우 20 → 0건 답변 근거가 틀리면 답변 전체를 믿을 수 없게 된다고 생각해, 근거를 고르는 단계를 판단 전용 모델 Jev로 바꿨습니다. GPT에게 고르게 하면 비용이 약 2.5배였고, 검색 가중치를 여러 값으로 바꿔 봐도 점수가 비슷한 수준에 머물렀기 때문입니다. 다만 처리 시간이 크게 늘어, 후보 수와 병렬 수를 조정해 선택 시간 중앙값을 9.090초에서 1.137초로 줄였습니다.
- 에이전트 실행 환경 설계: 사용자 정의 Skill과 승인 기반 실행, 편집 품질 82.5% → 91.2%(114건 평가) 회의록 정리처럼 사용자마다 반복하는 작업이 달라, 사용자가 직접 Skill로 정의해 다시 쓸 수 있게 했습니다. 그런데 AI가 문서를 함부로 바꾸면 사용자가 서비스를 믿고 맡길 수 없다고 판단해, 권한과 실행 범위는 코드가 검사하고 실제 반영은 사용자가 승인한 뒤에만 하도록 나눴습니다. 코드 검사만으로는 요청 누락을 잡지 못해, 의미 평가 후 한 번만 다시 쓰게 했습니다.
- 데이터 파이프라인 구축: PDF 복원율 45.17% → 89.89%, 약품 변환 비용 예상 $200 대비 $11.18 논문의 표와 수식이 깨지면 답변 근거가 되는 수치를 쓸 수 없어, 본문은 빠른 AnyDoc으로 추출하고 표와 수식은 원본 영역을 따로 판독하도록 처리 경로를 나눴습니다. 약품 데이터는 같은 문장을 한 번만 변환하고, 실시간 응답이 필요 없는 작업이라 Batch API를 써 약 4만 4천 건을 예산 안에서 처리했습니다.
수치는 모두 내부 평가 기준입니다.
- AI & Search: LangChain, LangGraph, Spring AI, RAG, LangSmith, LLM Evaluation, LLM Guardrail
- Backend: Java, Spring Boot, Python
- Data & Infra: MySQL, PostgreSQL, Redis, Elasticsearch, Weaviate, Docker, Docker Compose, GitHub Actions, Kafka
2026.04 — 현재 | AI SW 마에스트로 17기 | AWS EKS 배포 완료, QA 진행 중 | 팀 프로젝트 (3명 + 디자이너) | AI 파트 리드
- 시작 계기: 팀원이 제기한 문서 관리의 불편함을 디자인 싱킹으로 구체화했습니다. 저장만 해 둔 문서를 필요할 때 찾지 못하는 문제를 풀고자 했습니다.
- 팀 구성: 본인(AI 전체), 백엔드 1명(Spring 백엔드 전체), 프론트엔드와 DevOps 1명(프론트엔드, MSA 기반 AWS 배포), 외주 디자이너, 멘토 3명
- 사용 언어: AI 서비스 Python(FastAPI, LangChain, LangGraph), 문서 서비스 Java(Spring Boot), 프론트엔드 TypeScript(Next.js)
주요 개발
- RAG 과정의 검색 정확도 개선
- 문제: 문서 근거로 답하는 서비스에서 기존 검색이 근거를 놓치거나 답 없는 질문에도 근거를 붙여 답변 신뢰도가 흔들림.
- 판단: GPT 선택은 비용(약 2.5배)과 시간 부담, 가중치와 RRF 조정은 여러 값을 실험해도 점수가 비슷해, 요청 분류에서 먼저 검증한 Jev(정답 77 → 81/98건) 채택.
- 해결: 벤치마크상 한국어 의미 검색이 가장 좋은 BGE-M3와 정확한 용어를 잡는 BM25로 후보를 모으고 Jev가 최종 근거를 고르는 2단계 구조. 동일 후보와 블라인드 교차 채점으로 비교한 뒤 후보를 300개로 줄이고 병렬 4, 6, 8, 10을 비교해 정확도 차이 없이 가장 효율적인 8병렬로 조정.
- 성과: 답이 있는 80문항의 근거 충족률 66.25% → 91.25%.
- 사용자 정의 Agent Skill과 승인 기반 실행
- 문제: 사용자마다 반복 작업이 달라 모두 기능으로 만들 수 없고, AI 편집안이 요청을 빠뜨린 채 전달돼 같은 결과를 원하는 작업을 운에 맡기게 됨.
- 판단: 지침은 AI, 권한과 실행 범위 검사는 코드, 게시와 실제 반영은 사용자가 맡도록 책임 분리. 코드의 형식 검사만으로는 요청 누락을 못 잡아 LLM 의미 평가를 추가.
- 해결: 자연어 지침 작성, 검토, 게시와 권한 및 승인 우회 검사, 미리보기 후 별도 승인. 편집 결과는 의미 평가 후 최대 1회 재작성. 생성, 평가, 재작성은 단계별로 추적하도록 LangGraph 노드로 나누고, 게시한 Skill은 PostgreSQL에 불변 버전으로 저장.
- 성과: 편집 품질 94 → 104/114건(82.5% → 91.2%). 승인 전에는 문서가 바뀌지 않음을 확인. 통과하지 못한 편집안 20건 → 10건.
- PDF → Markdown 변환
- 문제: 논문 PDF의 표와 수식이 깨지면 Wiki와 답변의 근거가 되는 수치를 쓸 수 없음.
- 판단: 깨진 곳만 고치는 방식은 탐지가 오류를 놓쳤고, 전체 AI 변환은 표 및 수식 정확도와 비용이 부족해 내용 유형별 처리로 전환. 본문은 추출이 빠른 AnyDoc, 복원은 GPU 운영비가 드는 sLLM 대신 상용 LLM API.
- 해결: 본문은 AnyDoc으로 추출해 깨진 부분만 AI로 보완, 표와 수식은 원본 영역을 따로 판독, 그림은 원본 보존.
- 성과: PDF → Markdown 복원율이 기존 Docling만 사용할 때 약 45%에서 약 90%로 개선.
- AI 작업 취소와 변경 복구
- 문제: AI 작업은 모델 호출 사이에 문서, 폴더, Wiki를 여러 번 저장해, 취소해도 일부 변경이 남으면 사용자가 AI에게 작업을 맡길 수 없음.
- 판단: 모델에 반대 작업을 시키면 원래 값을, 전체 잠금은 장애 대응을 보장할 수 없어 실행 기록 기반의 역순 복구 선택.
- 해결: 취소 상태를 먼저 저장해 후속 쓰기를 막고 자식 작업부터 역순 복구. 여러 문서가 합쳐진 Wiki는 대상 기여만 빼고 재조립.
- 성과: 폴더 2개와 문서 6개 정리 작업을 9개 지점 각각에서 취소해도 원래 상태로 복원, 복구 중 모델 호출 없음.
- 문서의 Wiki 생성 병렬화: Kafka로 문서별 작업을 나눠 Worker 최대 4개로 처리해 문서 4개 분석 시간 282.11초 → 73.89초(약 74% 단축).
- MSA: 기능별로만 나누면 DB 부하는 그대로이고 서비스 간 호출만 늘어난다고 보고 데이터 소유권 기준 분리를 제안, 팀원 및 멘토와 경계와 통신 방식을 공동 설계.
2025.03 — 2025.12 | 부산대학교 졸업과제 | APK 내부 배포 사용자 6명 | 팀 프로젝트 (3명 + 디자이너) | 핵심 백엔드, 데이터 정제
- 시작 계기: 약품 정보가 흩어져 있어, 지금 건강 상태에서 특정 약을 먹어도 되는지 확인하기 어렵다는 문제에서 출발했습니다.
- 팀 구성: 본인(백엔드와 AI), Android 1명(Kotlin 앱 전반), 백엔드와 보안 1명(사용자 DB, 로그인, 문진표, AES-GCM), 디자이너
- 사용 언어: 백엔드와 챗봇 Java(Spring Boot, Spring AI), 의약품 데이터 정제 Python
주요 개발
- 데이터 정제 파이프라인 구축
- 문제: 약 4만 4천 건을 그대로 쉬운 설명으로 바꾸면 API 비용이 약 $200으로, 예산 안에서 모든 약의 설명을 제공할 수 없었음.
- 판단: 약 수를 줄이는 대신 같은 문장은 한 번만 변환. 실시간 응답이 필요 없는 작업이라 Batch API로 대기 시간을 받아들이고 비용을 낮춤.
- 해결: 문장 블록으로 나눠 완전 일치 문장을 통합하고 GPT Batch API로 변환한 뒤 약품별로 재연결. 2026년 코어 병렬 처리와 확장이 가능한 PySpark로 재현해 단계별 효과 측정.
- 성과: 전체 원문 변환 예상 비용 약 $200 대비 실제 API 지출 $11.18(전처리 인건비 제외). 재현 실험에서 완전 일치 중복 제거로 텍스트 744MB → 44.1MB(−94.1%).
- 개인 건강 정보 기반 답변 제공 AI 복약 챗봇 개발
- 문제: 약을 먹어도 되는지 확인하려는 사용자의 증상 표현과 약 효능 용어가 달라 검색이 어렵고, 개인화에 필요한 건강 정보는 외부 AI로 보낼 수 없었음.
- 판단: 동의어 사전은 증상이 많고 서로 겹쳐 의미 검색으로, 프로필 필터링은 걸러야 할 경우가 너무 많아 내부 판단으로 전환. 벡터 DB는 Milvus보다 가벼운 Weaviate, 오케스트레이션은 백엔드가 Spring이라 별도 Python 컨테이너 부하를 피해 Spring AI 사용.
- 해결: Weaviate 의미 검색과 AI 오케스트레이션으로 약품 탐색, 복약 위험, 섭취량별 처리 경로 구성. 임신 여부, 복용약, 기저질환은 내부 코드로 판단.
- 성과: 자연어 증상으로 약품 정보를 탐색하고, 해당 건강 프로필을 외부 LLM 입력에서 제외한 개인화 흐름 구현.
- 백엔드 기능 구현: Java, Spring Boot 기반 의약품 DB 설계, 검색과 자동완성, 복약 위험정보(DUR) 표출 구현. 부분 일치와 자동완성은 Elasticsearch로, 반복되는 위험정보 조회는 Redis 캐시로 처리해 검색 응답 5~7초 → 평균 0.8초. FCM 복약 알림과 로그, 딥링크 친구 초대, 가족 프로필 전환을 구현했습니다.
- 전시 피드백 반영: 부산대학교 대표 전시팀으로 두 차례 부스를 운영하며 받은 피드백 10건 대부분이 건강기능식품 요청이어서, 검색과 자동완성, 복용 주의와 병용 정보, 복약 알림과 기록, 챗봇 답변 대상까지 건강기능식품으로 확장했습니다.
Rhwp (2026.06): Claude Code에 작업 계획과 기여 규칙을 주고 이슈 분석부터 PR까지 자동화해, HWP/HWPX 저장 오류 수정 등 PR 7건 병합. Contributor로 등재됐습니다.
PR #1213 | 병합 | PR #1351 | 제출 | 전체 기여
- AWS 교육 (2026.06 — 2026.07): Cloud Practitioner Essentials, Machine Learning Engineering on AWS, Developing Generative AI Applications on AWS 이수
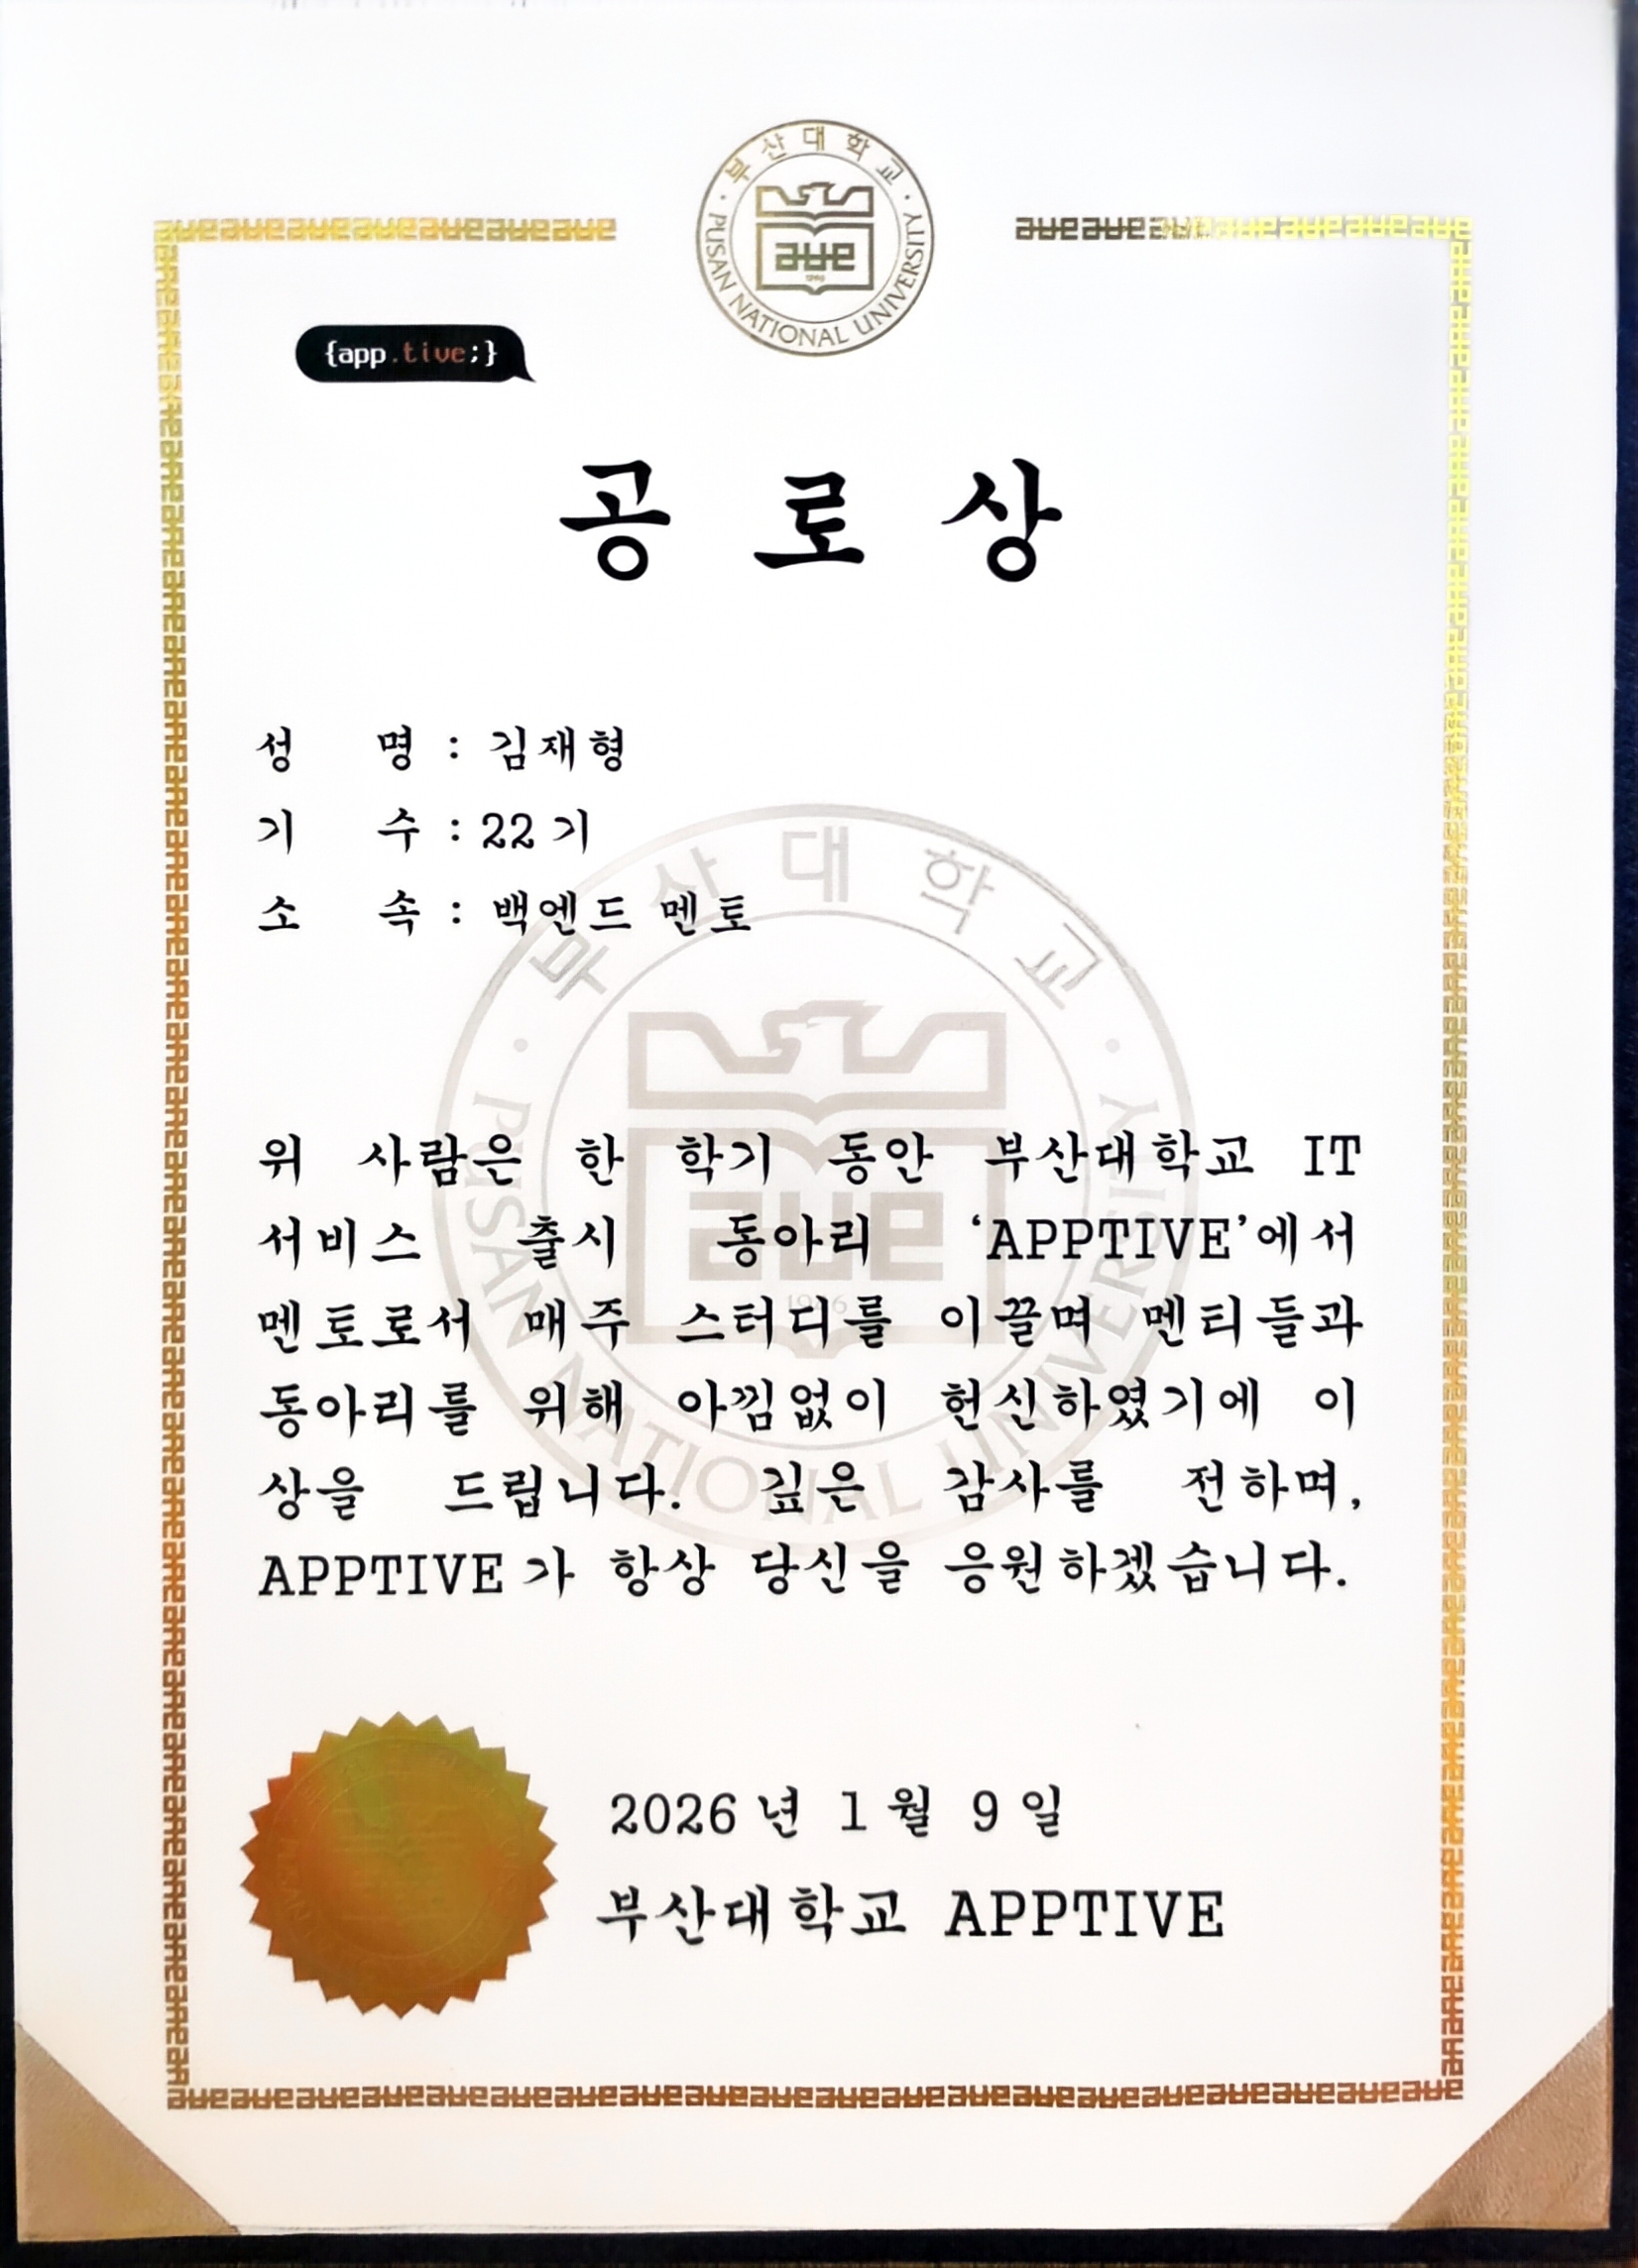
- 부산대학교 APPTIVE (2025.03 — 2026.01): Backend 멘티 및 멘토. 멘티 12명 대상 6회 멘토링과 코드 리뷰. HTTP, Servlet, REST API, DB 기초를 보강하는 커리큘럼 개편에 참여했습니다. 멘토 공로상 (2026.01.09)
- SK AI SUMMIT, K-ICT WEEK in Busan (2025.11 / 2025.07): 부산대학교 대표 전시팀으로 Pilltip 부스를 운영하며 방문자 100명 이상에게 시연하고 기술 질의응답을 진행했습니다.
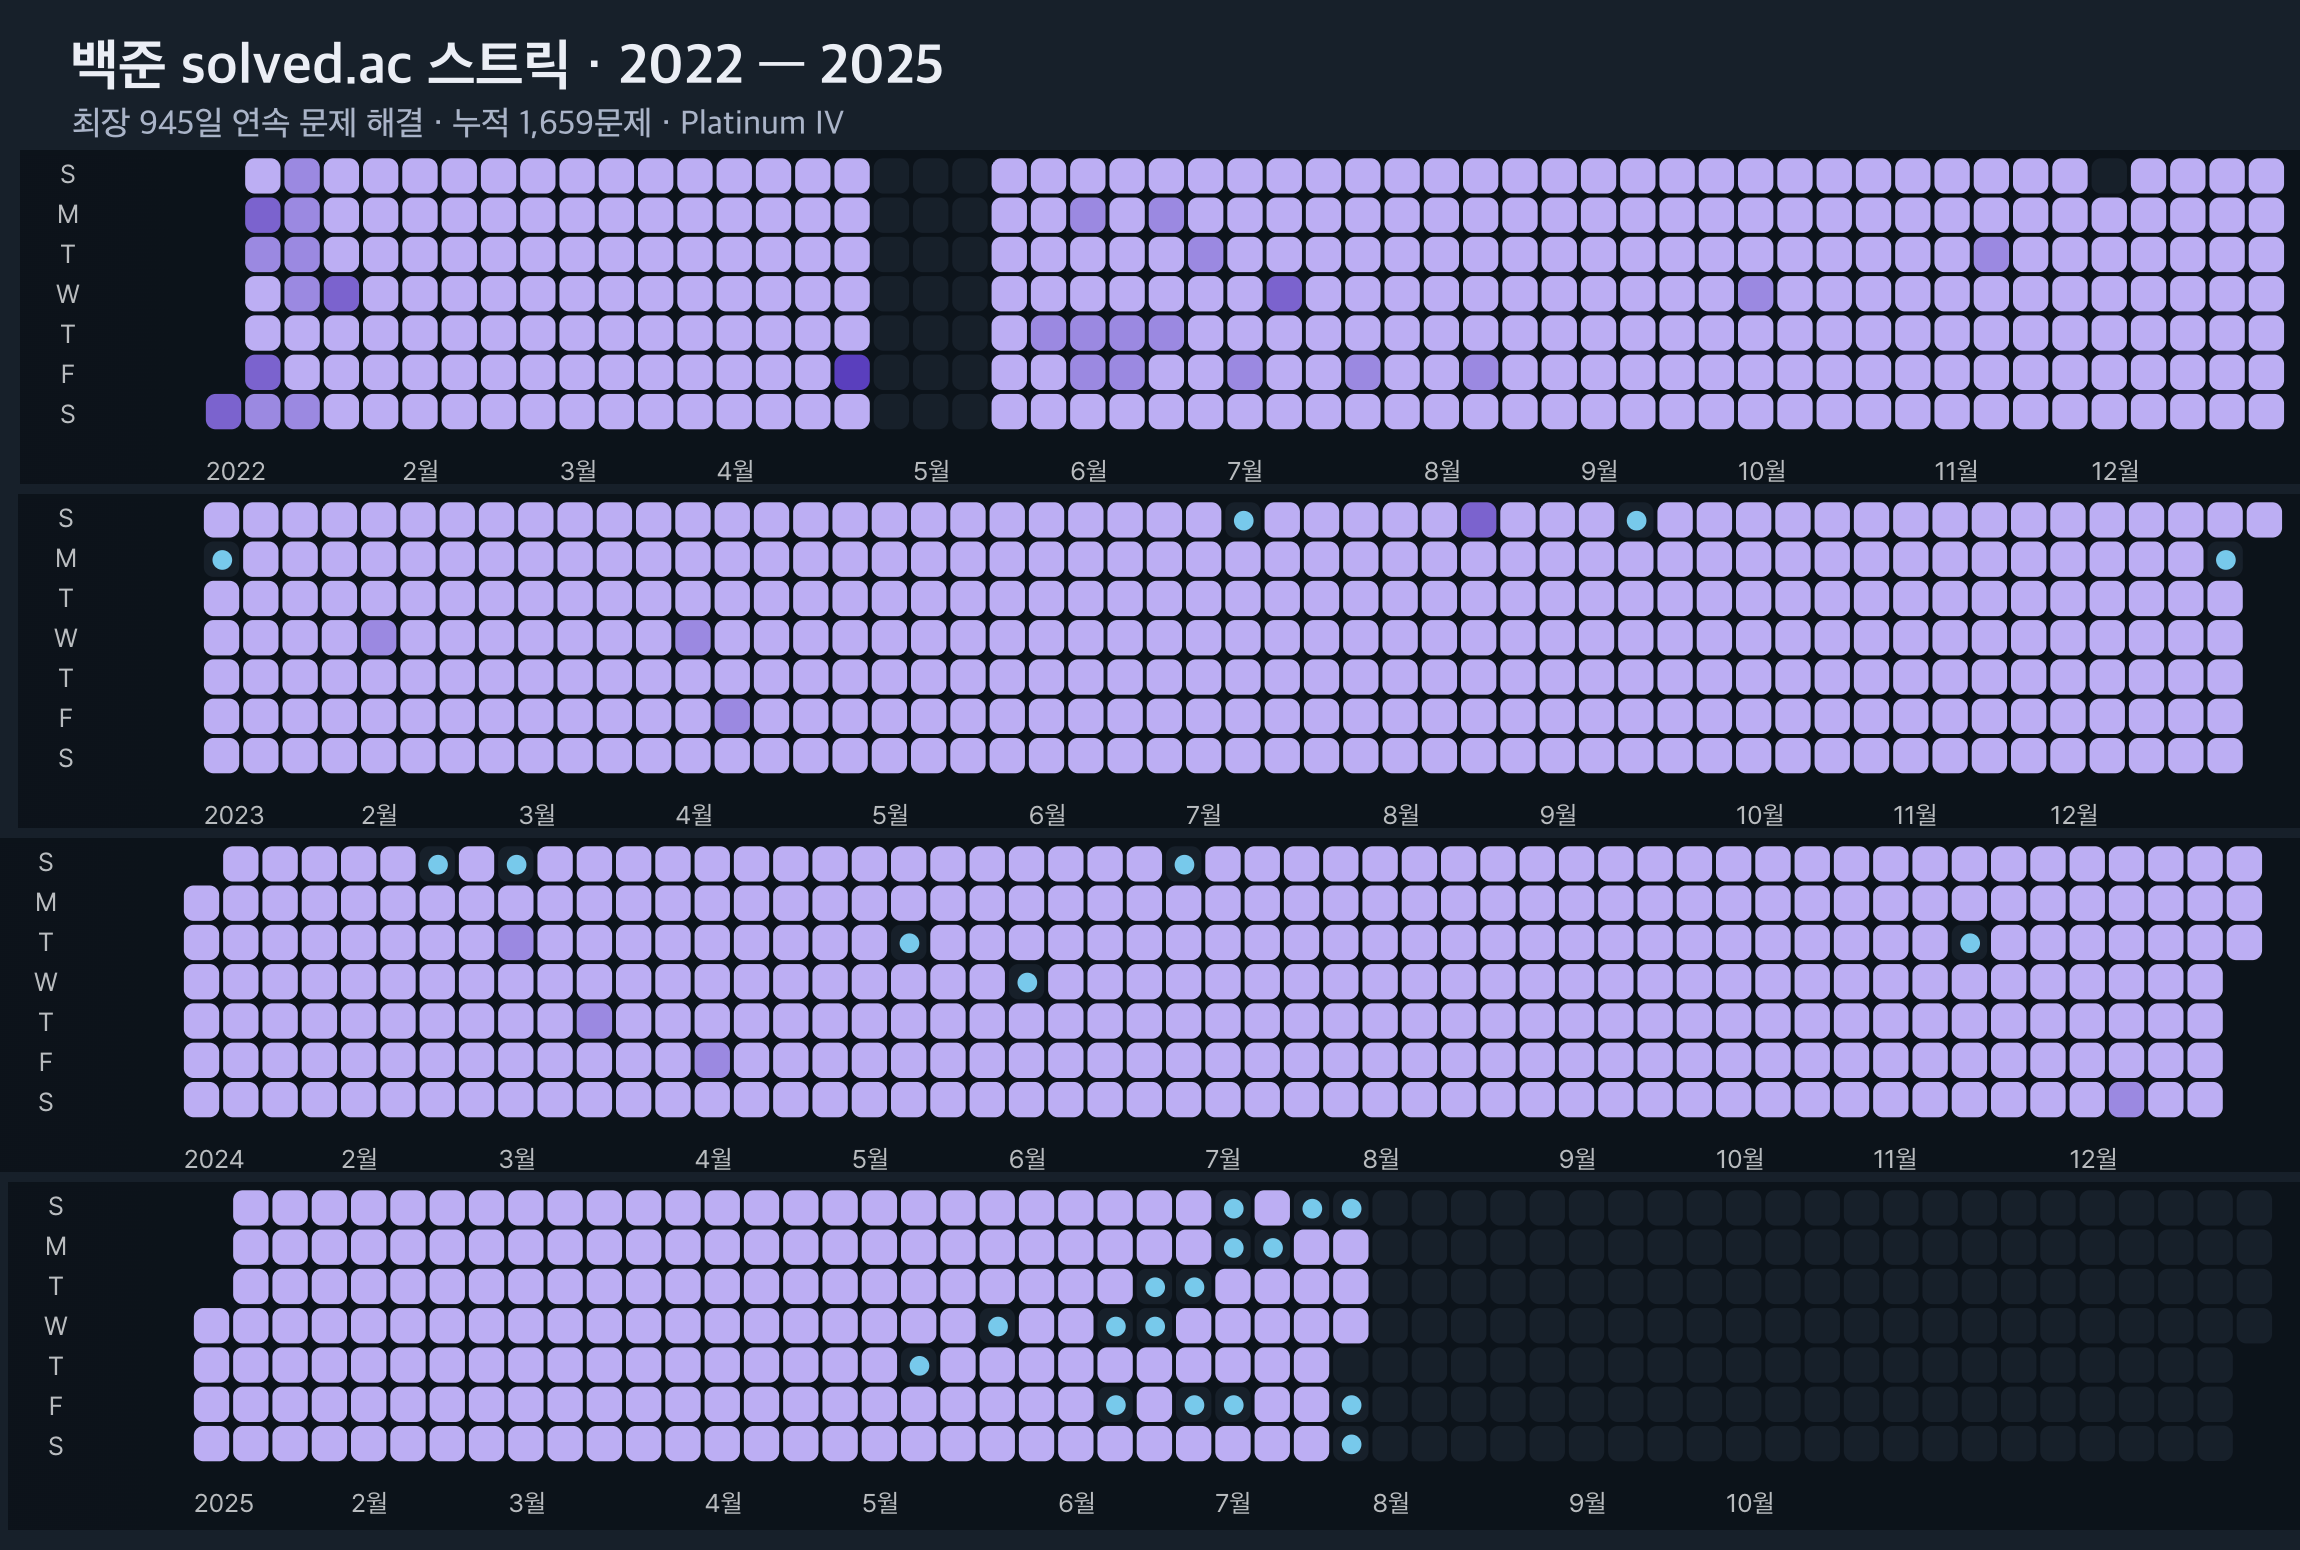
- 백준 945일 연속 문제 해결 (2022.02 — 2025.07): 하루 한 문제를 목표로 solved.ac 기준 최장 945일 연속 문제를 해결했습니다. 누적 1,659문제, Platinum IV. 풀이 저장소 | solved.ac
- 캡스톤디자인 금상 | 2025.10 | 소프트웨어와 인공지능 분과 / 부산대학교 정보의생명공학대학
- 부산 DATA WEEK 최우수상 | 2025.09 | 데이터 활용 우수사례 공모전 / 부산테크노파크
- AI LAUNCH 커리어스쿨 창업톤 장려상 | 2025.09 | KRYPTON X x Root Impact x Google.org
- SW중심대학 디지털 경진대회 후원기업상 | 2025.08 | SW중심대학협의회
- 부산대학교 | 2022.02 — 2026.02 (편입) | 평균 학점 4.12 / 4.5
- 대구대학교 | 2019.03 — 2022.02 (중퇴) | 평균 학점 4.2 / 4.5
- 정보처리기사 | 2025.09 | 한국산업인력공단